Jedna nazwa, dwa roboty
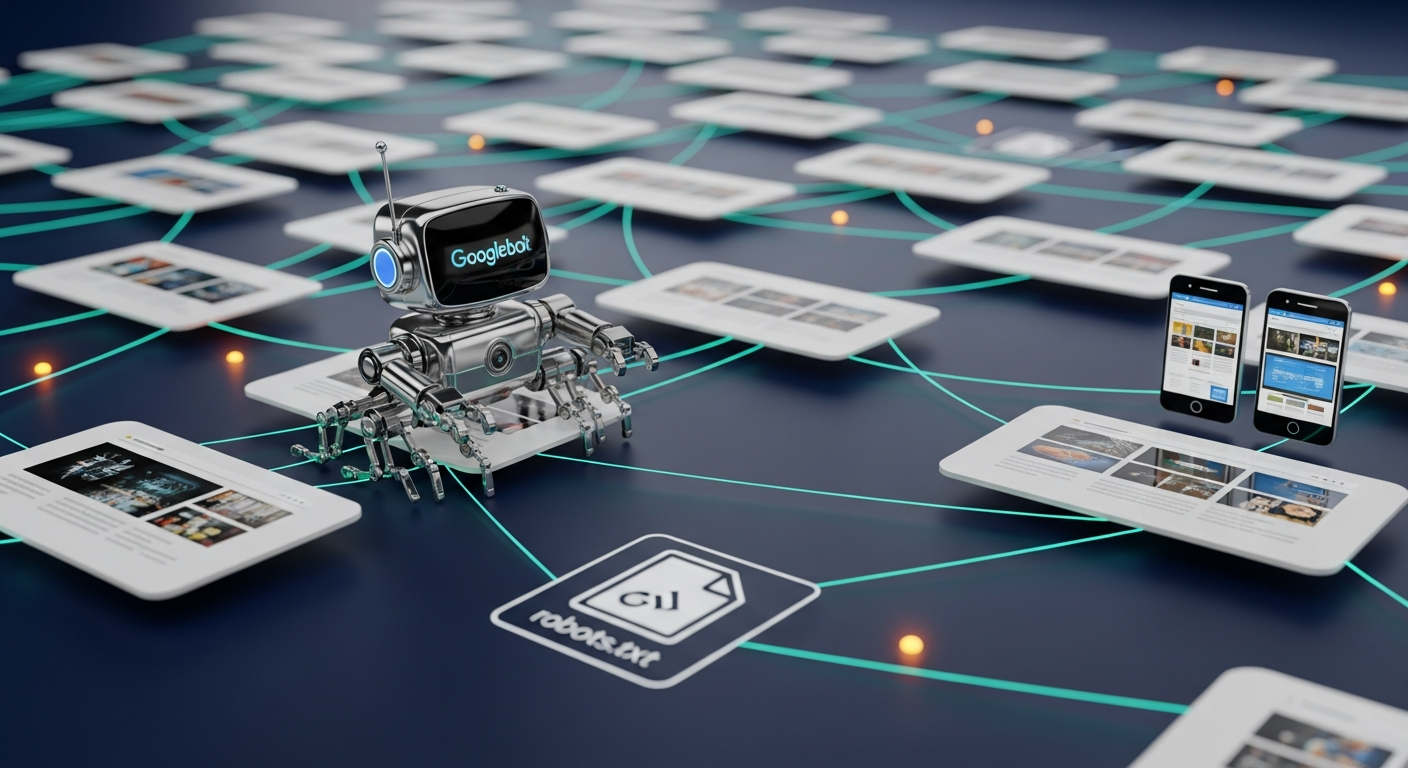
Googlebot to wspólna nazwa dwóch robotów Google Search: mobilnego, który udaje telefon, i komputerowego, który udaje przeglądarkę na biurku.1 Rozróżnia je nagłówek identyfikujący klienta, ale nie da się nimi sterować osobno: oba słuchają tego samego wpisu w pliku robots.txt, więc nie istnieje reguła obowiązująca wyłącznie jednego z nich.1 Dokumentacja zapowiada przy tym, że większość żądań wykonuje robot mobilny, a mniejszość komputerowy.1
Tydzień z Googlebotem w naszych logach
Sprawdziliśmy, jak wygląda ta zapowiedź w praktyce, licząc żądania z logów serwera za okres od 29 sierpnia do 4 września 2026 roku. Googlebot wykonał 1412 żądań do naszej domeny, ale rozkład jest zaskakujący: 916 z nich, czyli niemal dwie trzecie, dotyczyło jednego adresu: pliku robots.txt. Na treść zostaje 496 żądań i dopiero tu widać zapowiedzianą proporcję: 403 wykonał robot mobilny, 93 komputerowy. Odwrotnie jest przy samym robots.txt, o który pytał wyłącznie wariant komputerowy. W ciągu tygodnia robot odwiedził 322 różne adresy, przy 825 w mapie witryny, czyli około czterdziestu procent serwisu.2
Pierwsze dwa megabajty i nic więcej
Dobrze znać limit, który rzadko trafia do poradników: „Googlebot crawls the first 2MB of a supported file type, and the first 64MB of a PDF file”, a po jego przekroczeniu pobieranie zostaje przerwane i do dalszego przetwarzania idzie tylko pobrana część.1 Limit liczy się na danych nieskompresowanych, a każdy zasób wskazany w kodzie (arkusz stylów, skrypt) pobierany jest osobno i podlega temu samemu ograniczeniu.1 Praktyczny wniosek dotyczy kolejności w kodzie: treść powinna stać wysoko w dokumencie, a nie za kilobajtami skryptów i danych konfiguracyjnych. Nasze strony mieszczą się w granicach od 184 do 357 KB, więc do progu daleko, ale w sklepach z rozbudowanymi konfiguratorami bywa inaczej.
Jakie odpowiedzi dostaje i co z tego wynika
Rozkład kodów odpowiedzi z tego samego tygodnia wygląda tak: 1343 razy 200, pięćdziesiąt trzy razy przekierowanie stałe, trzynaście razy 404 i dwa razy informacja o braku zmian. Ciekawe są właśnie te trzynaście błędów, bo część z nich dotyczy plików arkuszy stylów generowanych przez mechanizm przyspieszający ładowanie: nazwy takich plików zmieniają się przy każdej przebudowie pamięci podręcznej, a robot pamięta poprzednie. Zjawisko nie jest groźne, ale pokazuje rzecz ogólniejszą: Googlebot wraca po adresy, które kiedyś istniały, więc każda zmiana schematu nazw plików zostawia po sobie ślad w postaci żądań do nieistniejących zasobów. Wpływa to na crawl budget tym mocniej, im większy serwis.
Logi mówią więcej niż raport
Search Console pokazuje datę ostatniego skanowania konkretnego adresu i statystyki zbiorcze, ale nie odpowie na pytania, na które odpowiada plik dziennika serwera: który wariant robota przyszedł, po co, jaki kod dostał i ile razy pytał o ten sam zasób. Analiza logów jest przy tym tania: wystarczy zliczyć pola po nazwie klienta, pamiętając o dwóch rzeczach. Po pierwsze, na serwerze współdzielonym trzeba odfiltrować własną domenę, inaczej liczy się cudzy ruch. Po drugie, sama nazwa w nagłówku nie dowodzi, że to naprawdę Googlebot. Google udostępnia listę adresów i metodę weryfikacji, a bez niej do zestawienia trafiają także podszywające się skanery. Reguły dostępu ustawia się w robots.txt, a wykluczenie z indeksu — znacznikiem noindex, który robot musi mieć szansę przeczytać.
Najczęstsze pytania
Czy można wydać osobne polecenia robotowi mobilnemu i komputerowemu?
Nie. Oba warianty obsługują ten sam wpis w pliku robots.txt, więc reguły dotyczą ich jednakowo.
Ile treści strony Googlebot faktycznie pobiera?
Pierwsze 2 MB pliku, licząc na danych nieskompresowanych, a przy dokumentach PDF pierwsze 64 MB. Dalsza część nie trafia do przetwarzania.
Jak sprawdzić, co robot naprawdę robi na stronie?
Najlepiej w logach serwera. U nas pokazały, że dwie trzecie żądań dotyczyło pliku robots.txt, czego żaden raport by nie ujawnił.
Źródła
1. Google Search Central, Googlebot — dwa warianty robota i wspólny wpis w robots.txt, przewaga wariantu mobilnego, limity pobierania 2 MB oraz 64 MB dla plików PDF liczone na danych nieskompresowanych. Zobacz dokumentację →
2. Dane własne essaseo.pl — analiza logów serwera z 29 sierpnia – 4 września 2026: 1412 żądań Googlebota, w tym 916 do pliku robots.txt, 403 żądania robota mobilnego i 93 komputerowego poza tym plikiem, 322 różne odwiedzone adresy oraz rozkład kodów odpowiedzi.
 Tadeusz Wolskizałożyciel ESSA SEO · 40+ zrealizowanych projektów · 5,0★ Google · 5,0★ Fiverr (30+ ocen)Zaktualizowano ⋅ 4 września 2026