Czym jest robots.txt
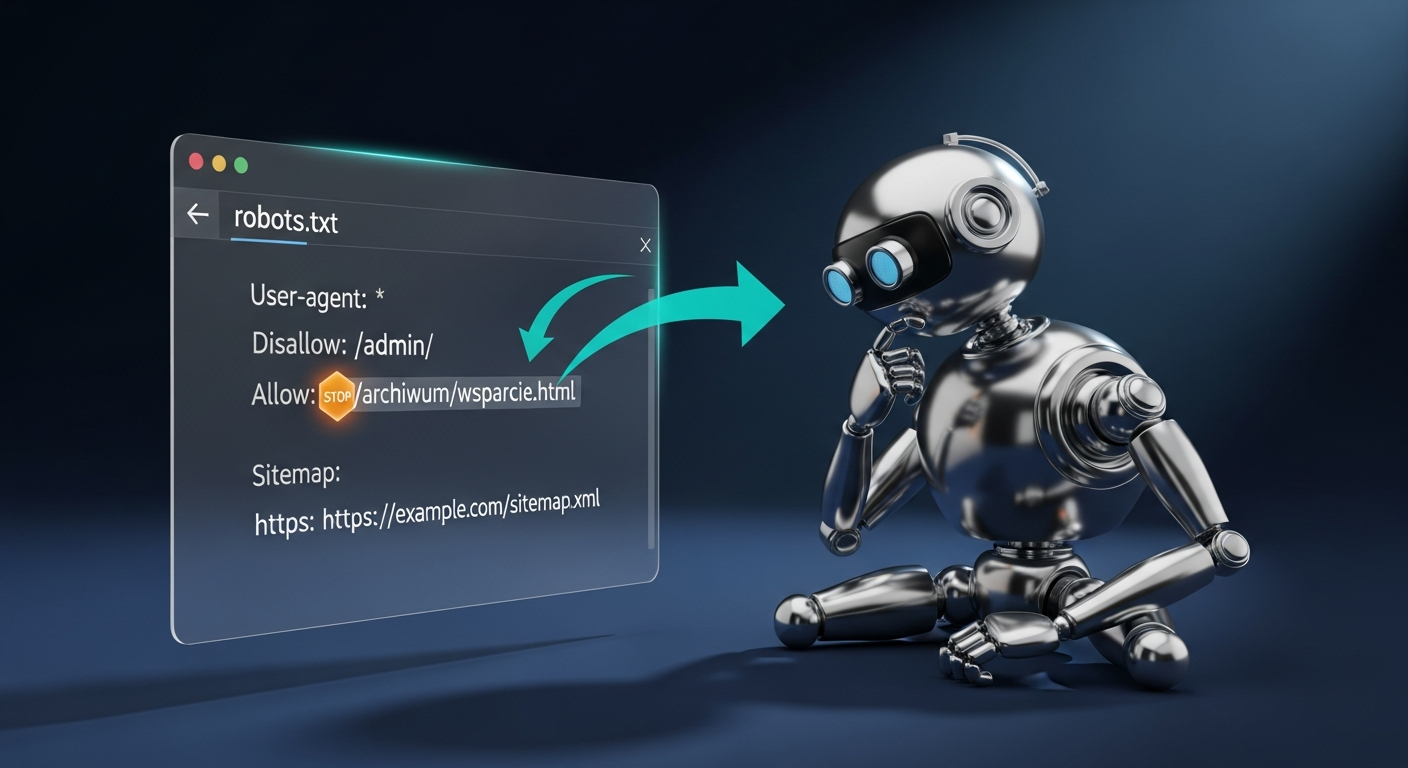
Robots.txt to plik tekstowy w katalogu głównym domeny, informujący roboty wyszukiwarek, które sekcje strony mogą odwiedzać, a które pominąć. Prosty w zapisie, a zaskakująco łatwo go źle zrozumieć.
Blokada nie usuwa z indeksu
Plik zawiera reguły „allow” i „disallow” dla poszczególnych ścieżek. Rozróżnienie, od którego wszystko się zaczyna, dokumentacja stawia w pierwszym akapicie: robots.txt służy głównie do tego, żeby nie przeciążać serwisu żądaniami, „it is not a mechanism for keeping a web page out of Google”.1
Adres zablokowany w tym pliku nadal może trafić do indeksu, jeśli prowadzą do niego odnośniki z innych witryn. Pojawi się wtedy w wynikach, tylko bez opisu. Do faktycznego wykluczenia służy noindex albo zabezpieczenie hasłem.1
Nazwana grupa unieważnia ogólną
To pułapka, która zjada więcej plików robots.txt niż literówki, bo nic w składni na nią nie wskazuje. Dokumentacja opisuje ją tak: „Only one group is valid for a particular crawler (…) Other groups are ignored”, a wprost o łączeniu: „User agent specific groups and global groups (*) are not combined”.2
Robot czyta więc tylko jedną grupę, najbardziej dopasowaną do swojej nazwy, i całkowicie pomija resztę pliku. Dopisanie osobnej sekcji dla wybranego robota nie uzupełnia reguł ogólnych, tylko je dla niego wyłącza.
Znaleźliśmy to we własnym pliku
Nasz robots.txt ma grupę ogólną z kilkoma wykluczeniami: panel administracyjny, koszyk, zamówienie, konto klienta i adresy z parametrami wyszukiwania. Niżej stoją osobne, nazwane grupy: dla Googlebota i Bingbota, każda z jedną regułą Allow: /.3
Zgodnie z zasadą wyżej oznacza to, że żadne z tych wykluczeń nie obowiązuje akurat tych dwóch robotów, czyli tych, dla których je napisano. Grupa ogólna działa na pozostałe crawlery, a Googlebot dostaje czyste „wchodź wszędzie”.
Skutki są u nas niewielkie, bo wykluczone ścieżki i tak wymagają logowania albo nie mają treści do zaindeksowania. Sama pomyłka jest jednak pouczająca: plik wygląda poprawnie i czyta się zgodnie z intencją, a działa inaczej. Widać to wyłącznie wtedy, gdy pamięta się o regule jednej grupy.
Praktyczny sprawdzian dla własnego pliku: dla każdej nazwanej grupy zapytać, czy zawiera wszystkie reguły, które mają dotyczyć tego robota. Jeśli nie, trzeba je w niej powtórzyć, bo z grupy ogólnej nic się nie dziedziczy.
Co jeszcze widać w tym pliku
Robots.txt jest publicznie dostępny pod stałym adresem, więc bywa czytany nie tylko przez roboty. Nasz zawiera jawną decyzję biznesową: otwieramy zarówno boty wyszukiwarek AI, jak i boty zbierające dane treningowe, bo zależy nam na cytowaniu marki w odpowiedziach.3
Z tego samego powodu plik nie powinien ujawniać wrażliwych ścieżek serwisu: wpisanie tam katalogu, którego nikt nie miał znaleźć, jest najprostszym sposobem, żeby go pokazać.
Robots.txt brany za zakaz
Reguły bywają traktowane jak zakaz obowiązujący każdego robota. Plik jest wyłącznie prośbą, którą grzeczne roboty, jak Googlebot, respektują, a pozostałe ignorują. Technicznym zabezpieczeniem treści jest hasło albo blokada po stronie serwera, nie wpis w pliku tekstowym.
Robots.txt, crawl budget i noindex
Robots.txt ogranicza zbędne odwiedziny robota, współpracuje ze znacznikiem noindex i jest jednym z pierwszych elementów sprawdzanych w audycie SEO. Jego wpływ na częstotliwość odwiedzin opisuje hasło crawl budget.
Najczęstsze pytania
Czy robots.txt usuwa stronę z indeksu?
Nie. Dokumentacja mówi wprost, że nie jest to mechanizm trzymania strony poza Google. Do usunięcia służy noindex albo zabezpieczenie hasłem.
Gdzie umieścić plik robots.txt?
W katalogu głównym domeny, pod adresem „domena.pl/robots.txt”. Inna lokalizacja nie zostanie rozpoznana.
Czy reguły z grupy ogólnej dotyczą też Googlebota?
Nie, jeśli w pliku istnieje osobna grupa dla Googlebota. Robot czyta tylko jedną, najbardziej dopasowaną grupę, a pozostałe ignoruje.
Czy wpisywać do robots.txt katalogi, których nikt nie ma znaleźć?
Nie. Plik jest publiczny, więc taki wpis działa jak drogowskaz do miejsca, które miało pozostać nieznane.
Źródła
1. Google Search Central, „Introduction to robots.txt” (odczyt 2026-08-21): „A robots.txt file tells search engine crawlers which URLs the crawler can access on your site. This is used mainly to avoid overloading your site with requests; it is not a mechanism for keeping a web page out of Google. To keep a web page out of Google, block indexing with noindex or password-protect the page”. Zobacz dokumentację Google →
2. Google Search Central, „How Google interprets the robots.txt specification” (odczyt 2026-08-21): „Only one group is valid for a particular crawler. Google’s crawlers determine the correct group of rules by finding in the robots.txt file the group with the most specific user agent that matches the crawler’s user agent. Other groups are ignored”; „User agent specific groups and global groups (*) are not combined”. Zobacz specyfikację →
3. Odczyt własnego pliku essaseo.pl/robots.txt z 2026-08-21: grupa ogólna zawiera pięć wykluczeń, a niżej stoją osobne grupy dla Googlebota i Bingbota z regułą „Allow: /”. Plik otwiera jawnie roboty wyszukiwarek AI oraz roboty zbierające dane treningowe i blokuje trzy crawlery uznane za zbędne.
 Tadeusz Wolskizałożyciel ESSA SEO · 40+ zrealizowanych projektów · 5,0★ Google · 5,0★ Fiverr (30+ ocen)Zaktualizowano ⋅ 21 sierpnia 2026