Czym jest techniczne SEO
Techniczne SEO to ta część optymalizacji, która odpowiada na jedno pytanie: czy wyszukiwarka może stronę pobrać, odczytać i zrozumieć. Nie zajmuje się tym, czy treść jest dobra ani czy ktoś do niej linkuje. Pilnuje warstwy pod spodem: kodów odpowiedzi, adresów kanonicznych, danych strukturalnych, szybkości i dostępności dla robota. Jej wyróżnikiem jest to, że prawie wszystko da się w niej sprawdzić maszynowo i rozstrzygnąć zero-jedynkowo.
Zakres: rzeczy, które albo są, albo ich nie ma
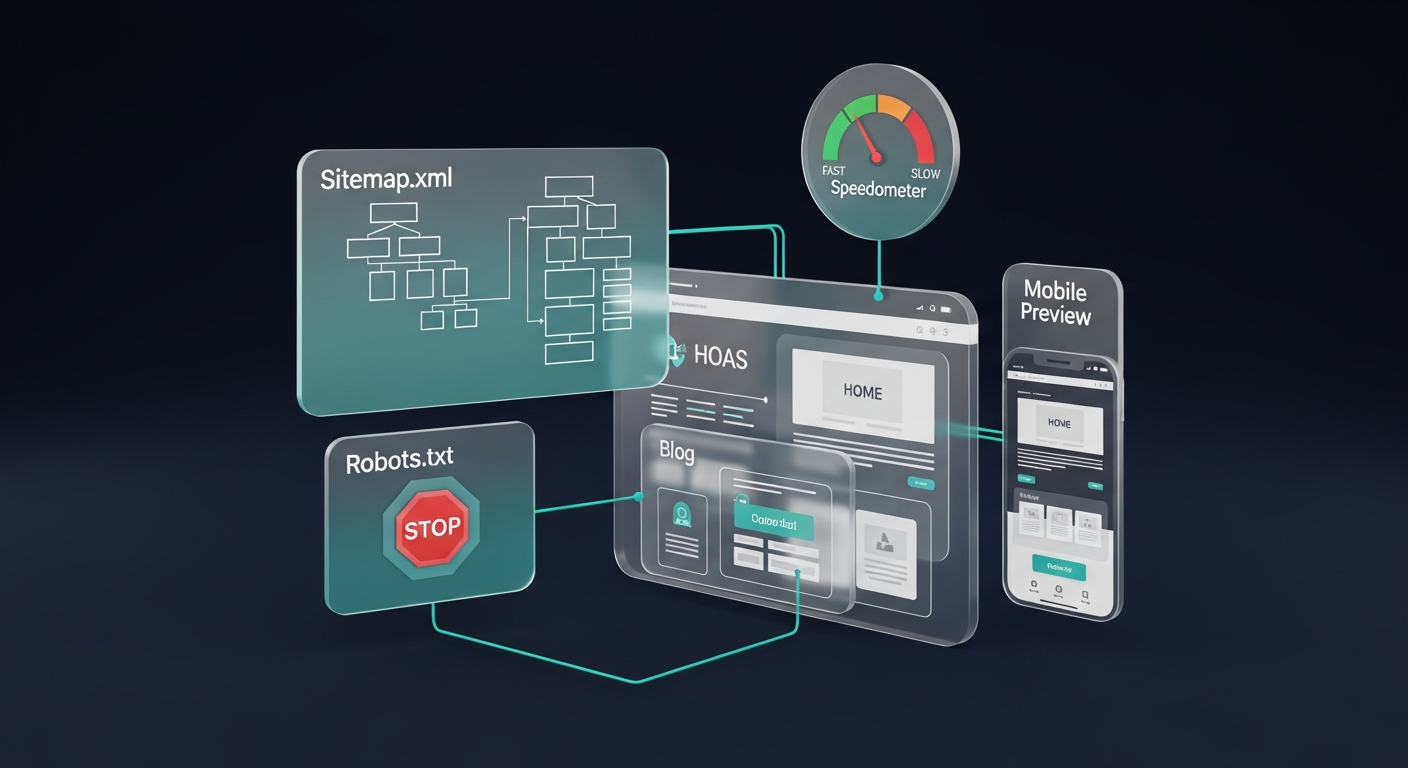
Techniczne SEO bywa opisywane jako worek bez dna, a w praktyce sprowadza się do skończonej listy punktów kontrolnych. Na każdej stronie sprawdza się kod odpowiedzi serwera, obecność i unikalność znacznika title, opis w metadanych, dokładnie jeden nagłówek h1, adres kanoniczny wskazujący na samego siebie, atrybut języka, znacznik viewport dla urządzeń mobilnych oraz to, czy dane strukturalne w ogóle parsują się jako poprawny dokument.
Na poziomie całego serwisu dochodzą: mapa witryny zgodna ze stanem faktycznym, robots.txt niewykluczający niczego przez pomyłkę, brak zapętlonych przekierowań i czas ładowania. Lista jest długa, ale ma koniec. To ją odróżnia od pracy nad treścią, gdzie nigdy nie wiadomo, czy tekst jest już dość dobry.
Zdanie z dokumentacji, które ustawia proporcje
Technicznemu SEO przypisuje się czasem moc sprawczą, której nie ma. Google zaczyna swój przewodnik po działaniu wyszukiwarki od zastrzeżenia: „Google doesn’t guarantee that it will crawl, index, or serve your page, even if your page follows the Google Search Essentials”.1 Przy opisie samego indeksowania powtarza to jeszcze dobitniej: „Indexing isn’t guaranteed; not every page that Google processes will be indexed”.
W tym samym miejscu dokumentacja wymienia trzy najczęstsze powody, dla których strona nie trafia do indeksu: niska jakość treści, reguły w metaznacznikach zakazujące indeksowania i konstrukcja witryny utrudniająca indeksowanie. Tylko jeden z tych trzech punktów to czysta technika. Poprawna warstwa techniczna usuwa przeszkody, przez które dobra treść mogłaby nie dojść do indeksu. Na tym jej rola się kończy.
Nasz audyt 786 podstron: cztery usterki, żadnej krytycznej
Żeby sprawdzić, ile realnie waży ta lista, przepuściliśmy przez nią własny serwis 20 sierpnia 2026: wszystkie 786 polskich adresów z mapy witryny.2 Komplet punktów obowiązkowych wyszedł czysto: każda strona odpowiada kodem 200, każda ma tytuł, opis w metadanych, adres kanoniczny, atrybut języka, znacznik viewport i dane strukturalne parsujące się bez błędu.
Zostały cztery drobiazgi. Dwadzieścia sześć stron ma po dwa nagłówki h1 zamiast jednego. Dwa adresy mają adres kanoniczny wskazujący gdzie indziej i oba okazały się pustymi szablonami systemowymi, które wyciekły do mapy witryny. Trzy tytuły powtarzają się na sześciu stronach, dwa opisy na czterech. W obu przypadkach chodzi o te same szablony sklejone z prawdziwymi stronami.
Wynik jest przy tym mylący, jeśli poprzestać na liczbach. Ten sam serwis ma sześć podstron bez ani jednego odnośnika wewnętrznego, czego audyt techniczny nie zgłosi, bo każda z nich odpowiada poprawnie i ma komplet znaczników. Zdana technika i realny problem potrafią spokojnie współistnieć.
Co robić, gdy audyt techniczny wychodzi czysto
Czysty wynik jest momentem, w którym warto przestać dokładać narzędzia, a zacząć czytać to, co one znalazły. Nasz audyt oznaczył jako duplikat opis metadanych strony bloga. Sam duplikat okazał się nieciekawy, ale w tym opisie stała informacja o słowniku liczącym 492 pojęcia, podczas gdy realnie jest ich 235. Maszyna znalazła kształt, człowiek dopiero po przeczytaniu znalazł nieprawdę.
Dlatego po zamknięciu listy technicznej sensowna kolejność jest taka: sprawdzić, czy do każdej strony prowadzi jakikolwiek odnośnik, przeczytać własne tytuły i opisy pod kątem zgodności z treścią, a dopiero potem wrócić do metryk wydajności. Stały rytm przeglądów działa lepiej niż audyt robiony w reakcji na zauważony spadek, bo do tego czasu przyczyna zwykle zdążyła się zdublować.
Technika, indeksowanie i audyt
Praktyczny zakres tego obszaru obejmuje indeksowanie, szybkość strony, poprawność adresów kanonicznych i danych strukturalnych. Przy dużych serwisach dochodzi crawl budget, a całość spina okresowy audyt SEO. Warstwę techniczną porządkujemy na starcie każdej współpracy w ramach pozycjonowania stron, bo poprawki w treści zrobione na zepsutym fundamencie trzeba potem robić drugi raz.
Najczęstsze pytania
Od czego zacząć naukę technicznego SEO?
Od trzech etapów pracy wyszukiwarki: pobrania strony, zaindeksowania i pokazania w wynikach. Google zaznacza, że nie wszystkie strony przechodzą przez każdy z nich. To wyjaśnia większość późniejszych pytań.
Czy techniczne SEO wymaga umiejętności programowania?
Nie do samego audytu. Podstawowa znajomość HTML pomaga przy czytaniu wyników, ale większość poprawek w typowym systemie zarządzania treścią robi się bez pisania kodu.
Czy czysty audyt techniczny oznacza, że strona będzie widoczna?
Nie. Dokumentacja Google mówi wprost, że indeksowanie nie jest gwarantowane nawet przy spełnieniu wszystkich wymagań. Technika zdejmuje przeszkody, ale nie tworzy powodu, żeby stronę pokazać.
Jak często robić audyt techniczny?
W stałym rytmie, nie po zauważeniu spadku. Wtedy audyt służy do znalezienia jednej przyczyny, a nie do rozplątywania kilku nałożonych na siebie.
Źródła
1. Google Search Central, In-depth guide to how Google Search works: „Google doesn’t guarantee that it will crawl, index, or serve your page, even if your page follows the Google Search Essentials”; „Google Search works in three stages, and not all pages make it through each stage”; „Indexing isn’t guaranteed; not every page that Google processes will be indexed”; wymienione przyczyny problemów z indeksowaniem: „The quality of the content on page is low”, „Robots meta rules disallow indexing”, „The design of the website might make indexing difficult”. Zobacz dokumentację Google → (odczyt 2026-08-20).
2. Audyt własny essaseo.pl z 2026-08-20 na 786 polskich adresach z mapy witryny: 786 odpowiedzi 200; komplet tytułów, opisów, adresów kanonicznych, atrybutów języka, znaczników viewport i poprawnie parsujących się danych strukturalnych. Odchylenia: 26 stron z dwoma nagłówkami h1, 2 adresy z kanonicznym wskazującym na inną stronę, 3 powtórzone tytuły na 6 stronach, 2 powtórzone opisy na 4 stronach.
 Tadeusz Wolskizałożyciel ESSA SEO · 40+ zrealizowanych projektów · 5,0★ Google · 5,0★ Fiverr (30+ ocen)Zaktualizowano ⋅ 20 sierpnia 2026