Czym jest blokowanie indeksowania
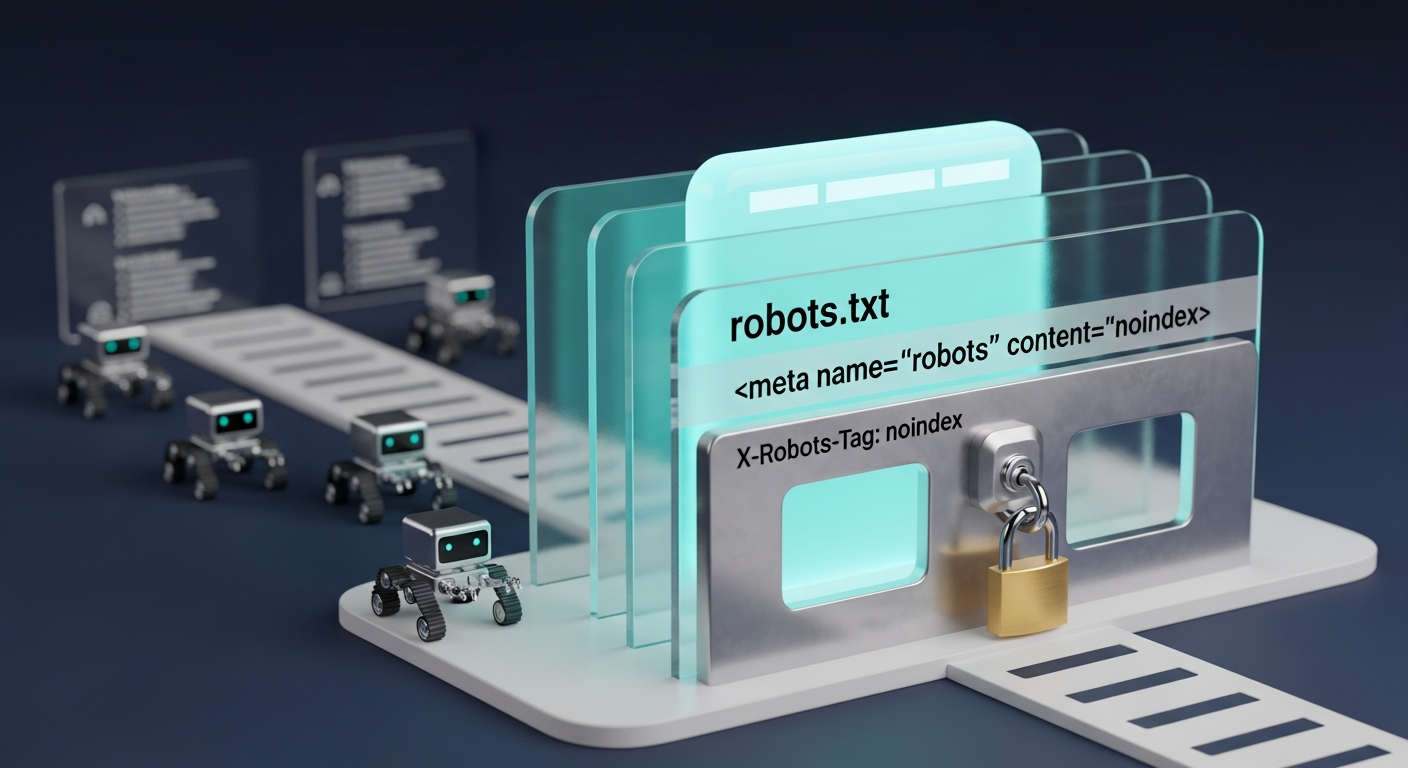
Blokowanie indeksowania to zestaw sposobów na to, żeby strona nie pojawiała się w wynikach wyszukiwania. Słowo „blokowanie” sugeruje przy tym jedną czynność o jednym skutku, a metody różnią się dwiema rzeczami, o które prawie nikt nie pyta: przed kim właściwie blokują i na jak długo.
Ten jeden sposób Google odradza wprost
Zacznijmy od zdania, które w polskich poradnikach praktycznie nie występuje, a stoi w dokumentacji o usuwaniu treści z wyników: „Don’t use robots.txt as a way to block your page”.1
Powód jest mechaniczny. Reguła w pliku robots zabrania robotowi wejścia na stronę, a żeby zobaczyć zakaz indeksowania umieszczony na stronie, robot musi na nią wejść. Blokując dostęp, blokuje się także dostarczenie własnej instrukcji. Adres może wtedy trafić do wyników z samego odnośnika prowadzącego do niego z zewnątrz. Szerzej opisuje ten plik hasło o pliku robots.txt.
Metody różnią się tym, kogo wykluczają
Dostępne sposoby lepiej ustawić nie według wyobrażonej „siły”, tylko według zasięgu wykluczenia, bo to on decyduje, czy dana metoda pasuje do sytuacji.
Usunięcie treści z serwera jest najszersze: „It also ensures that other people can’t access your page”.1 Znika i z wyników, i z internetu. Hasło dostępu wyklucza wszystkie roboty naraz, ale zostawia stronę ludziom, którzy je znają. Znacznik noindex działa najwęziej i zarazem najprecyzyjniej: wyklucza z wyników „regardless of whether other sites link to it”, czyli niezależnie od tego, kto linkuje z zewnątrz.2 Strona zostaje dostępna dla każdego, kto zna adres. Gdzie dokładnie ten znacznik zapisać, tłumaczy hasło o tagu noindex.
Różnica wobec pliku robots jest tu zasadnicza i warto ją zapamiętać w tej formie: noindex działa mimo linków z zewnątrz, a reguła w robots.txt przez te linki bywa obchodzona.
Blokada działa naprzód, a narzędzie usuwania wygasa
Drugi wymiar to czas. Każda z tych metod dotyczy przyszłości: mówi robotowi, co ma robić przy następnej wizycie. Adres, który jest już w wynikach, wymaga osobnej operacji, a i ona nie jest wieczna: „Requests made in the Removals tool last for about 6 months”.1
Narzędzie usuwania kupuje więc czas na wprowadzenie właściwej blokady, samo nią nie będąc. Z tego wynika kolejność, której nie da się odwrócić: najpierw noindex na stronie, która pozostaje dostępna dla robota, a dopiero po jej zniknięciu z wyników ewentualna blokada w robots.txt. Wykonane odwrotnie, drugie działanie unieważnia pierwsze. Skutkiem bywa wtedy wpis w raporcie, który wygląda na usterkę, a jest zapisem naszej własnej decyzji. Mówi o tym hasło o błędzie indeksowania.
Zablokowane roboty posłuchały. I to niczego nie zmienia
Sprawdziliśmy, jak nasza własna blokada działa w praktyce. W logach serwera z ośmiu dni (25 sierpnia do 1 września 2026, blisko 70 tysięcy żądań) odszukaliśmy trzy roboty, które wykluczamy regułą w pliku robots.3
Posłuszeństwo okazało się pełne. Dwa z nich odwiedziły serwis 53 razy i za każdym razem pobrały wyłącznie plik robots.txt. Nie było ani jednego żądania pod jakąkolwiek stronę treści. Trzeci nie pojawił się w ogóle. Dla kontroli, czy pomiar faktycznie coś widzi, policzyliśmy roboty dozwolone w tym samym oknie: 1759 żądań, 2994, 650, 217. Filtr działa, zero jest zerem prawdziwym.
I tu wychodzi rzecz, która całą sprawę wyjaśnia lepiej niż każda definicja: jedyne, co „zablokowany” robot od nas pobrał, to plik z instrukcją, żeby sobie poszedł. Posłuszeństwo dotyczyło odwiedzin, nie indeksu. Nawet przy stuprocentowej skuteczności taka blokada nie usunęłaby z wyników ani jednego adresu, bo robot nigdy nie zobaczył strony, a więc nie mógł zobaczyć na niej zakazu. Stąd próg praktyczny: jeśli zależy Ci na wyniku w wyszukiwarce, blokuj tam, gdzie robot musi wejść, żeby zobaczyć zakaz. Plik robots.txt służy do oszczędzania odwiedzin, czyli do zarządzania crawl budgetem.
Najczęstsze pytania
Czy robots.txt usuwa stronę z wyników?
Nie. Dokumentacja wprost odradza używanie tego pliku do blokowania strony. Reguła zabrania odwiedzin, a nie obecności w indeksie.
Jaka jest kolejność przy stronie już zaindeksowanej?
Najpierw noindex na stronie dostępnej dla robota, potem odczekanie na jej zniknięcie z wyników, dopiero na końcu ewentualna blokada dostępu.
Czy narzędzie usuwania załatwia sprawę?
Tymczasowo. Zgłoszenia działają około sześciu miesięcy, więc kupują czas na wprowadzenie właściwej blokady.
Co wybrać, gdy strona ma zniknąć także dla ludzi?
Usunięcie treści z serwera. Jako jedyne sprawia, że dostępu nie mają również osoby znające adres.
Źródła
1. Google Search Central, Remove information from Google — odradzenie pliku robots.txt jako metody blokowania, zasięg poszczególnych metod oraz okres ważności zgłoszeń w narzędziu usuwania. developers.google.com/search/docs/crawling-indexing/remove-information (odczyt 1.09.2026).
2. Google Search Central, Block search indexing with noindex — działanie znacznika niezależnie od odnośników z innych witryn. developers.google.com/search/docs/crawling-indexing/block-indexing (odczyt 1.09.2026).
3. Pomiar własny z 1.09.2026: odczyt logów dostępu serwera z okresu 25.08–1.09.2026 (69 796 żądań) pod kątem zachowania robotów wykluczonych regułą w naszym pliku robots.txt oraz tego, jakie zasoby faktycznie pobrały.
 Tadeusz Wolskizałożyciel ESSA SEO · 40+ zrealizowanych projektów · 5,0★ Google · 5,0★ Fiverr (30+ ocen)Zaktualizowano ⋅ 1 września 2026